
从一次指令数对不上的小事说起
我以前在琢磨材质优化的时候,碰到过一个想不通的现象:一张 BaseColor 贴图,先乘一个色调 Vector 参数、再乘一个亮度 Scalar 参数——很常见的写法。但我把同样的计算换了个连法,材质编辑器底部显示的 Shader 指令数居然不一样。
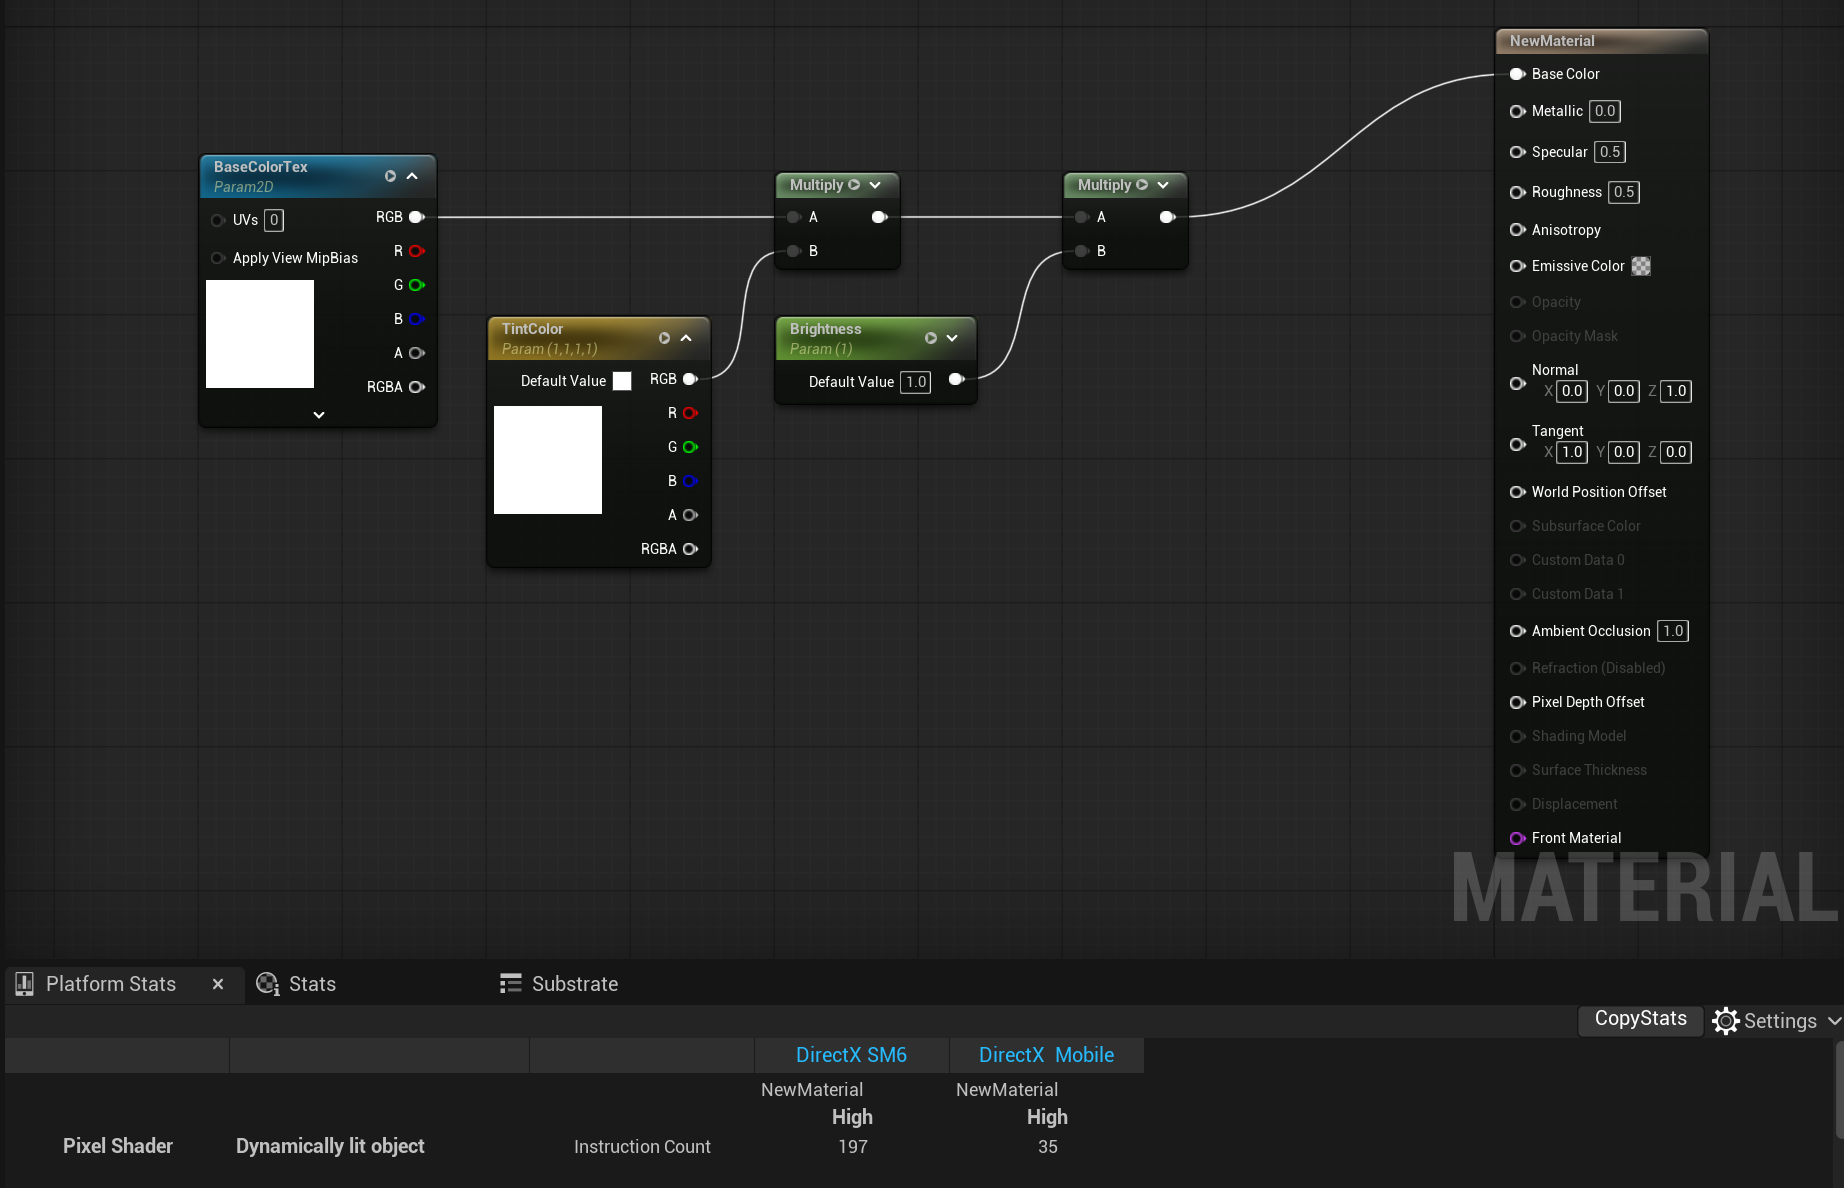
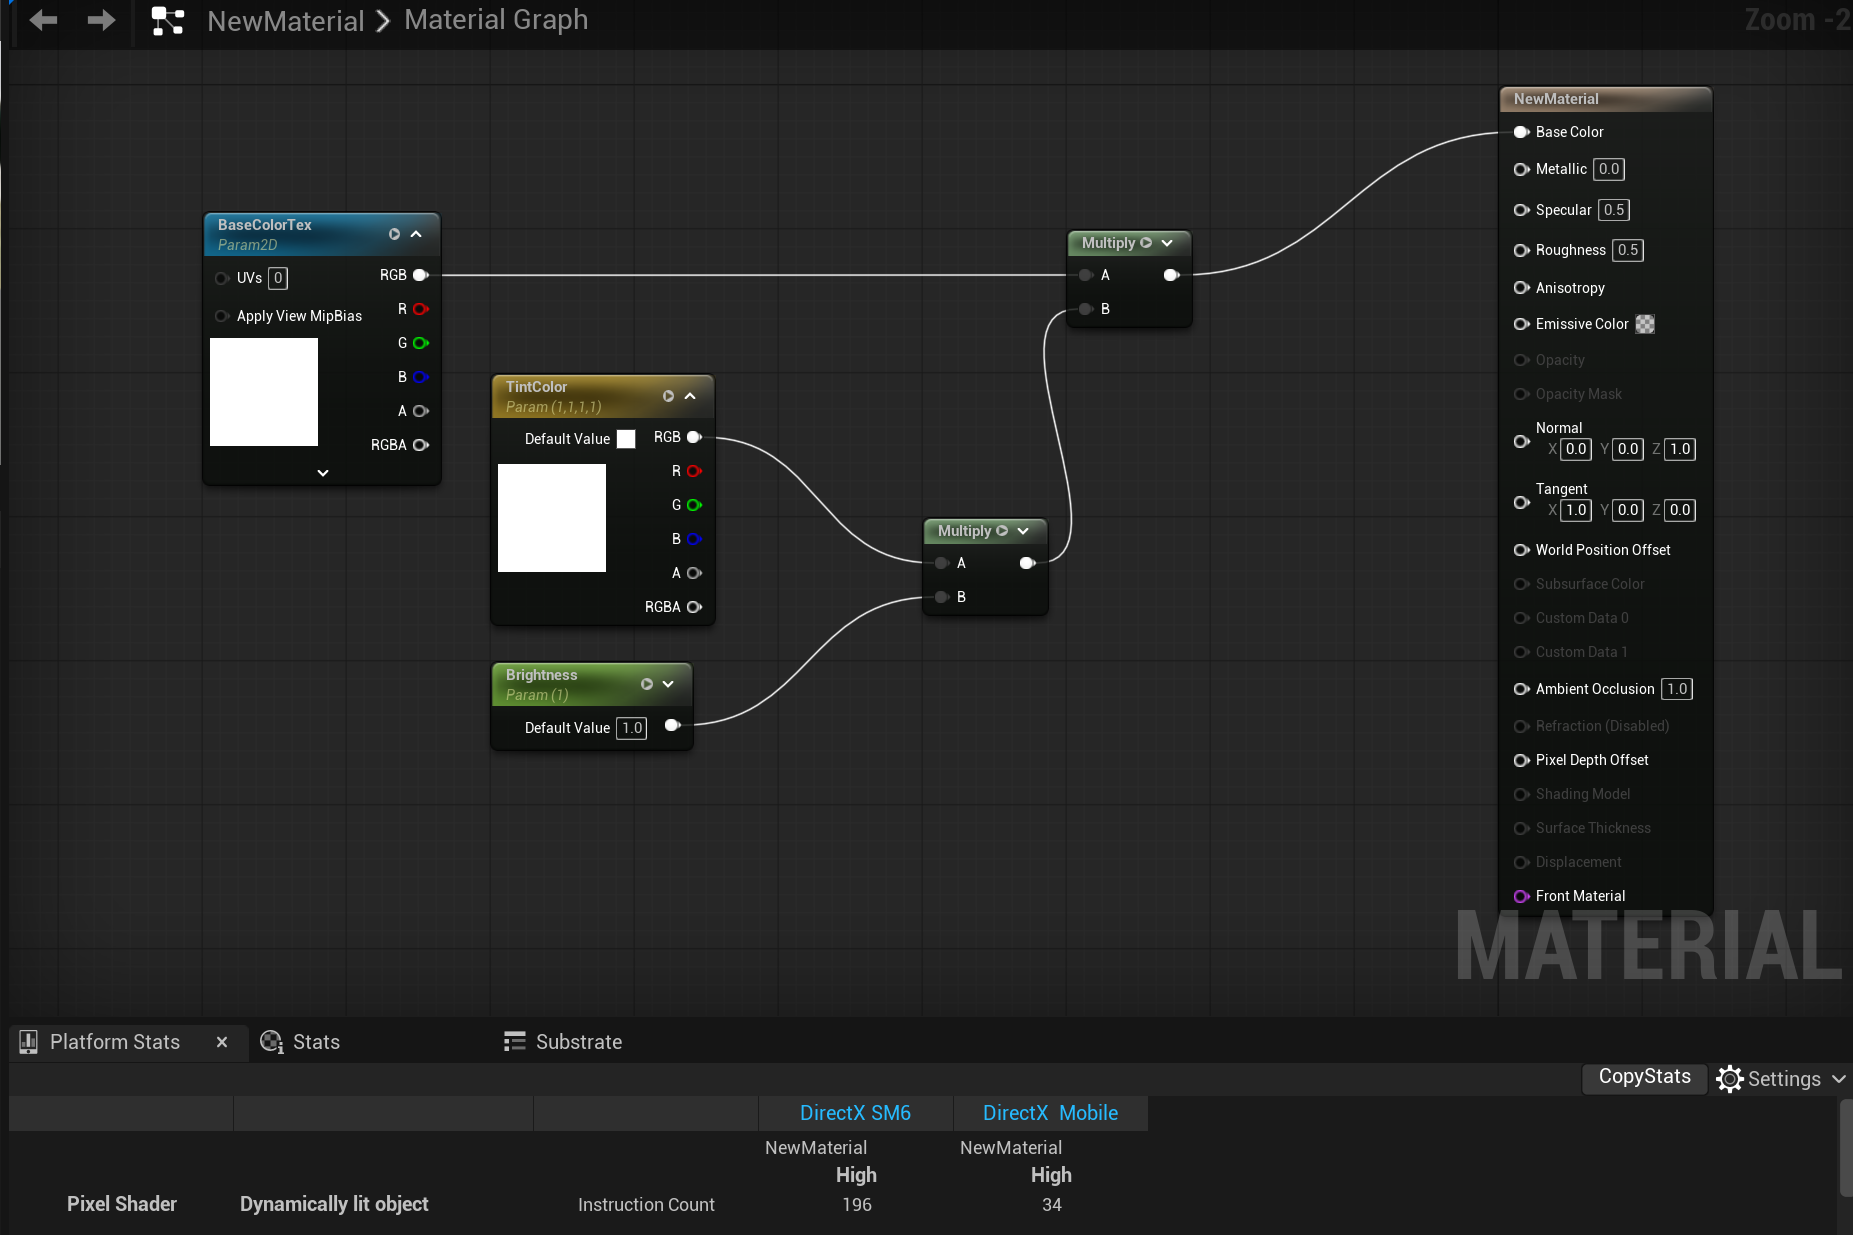
差别就在乘法的结合顺序上。写法二里,"色调 × 亮度"这一步跟像素毫无关系——两个输入都是材质参数,整张图每个像素算出来的值一模一样。引擎识别出这种无像素差异的计算,把它挪到 CPU 上预先算好,结果通过 uniform 传给 GPU,于是 GPU 上只剩"贴图 × 结果"这一次乘法。这个机制就是常量折叠(Constant Folding)。理解它之后,我才算真正明白 UE 的材质编译器在背后替我做了什么。
翻译器怎么决定什么能折叠
UE 的材质编译走 Legacy 路径时(FHLSLMaterialTranslator),每个表达式节点编译完都会产生代码块。翻译器对代码块有两种去处:逐像素变化的(UV、法线、顶点色这类),只能内联进 HLSL 让 GPU 逐像素执行;无像素差异的,则走 AddUniformExpression,进入一个叫 UniformExpressions 的集合——这才是折叠的入口。
// FHLSLMaterialTranslator::AddUniformExpressionInner(核心逻辑节选)
// 同一个 UniformExpression 只要 IsIdentical 就复用,不重复计算
for (int32 ExpressionIndex = 0; ExpressionIndex < UniformExpressions.Num(); ++ExpressionIndex)
{
    FMaterialUniformExpression* TestExpression =
        UniformExpressions[ExpressionIndex].UniformExpression;
    if (TestExpression->IsIdentical(UniformExpression))
    {
        for (int32 ChunkIndex = 0; ChunkIndex < CurrentScopeChunks->Num(); ++ChunkIndex)
        {
            FMaterialUniformExpression* OtherExpression =
                (*CurrentScopeChunks)[ChunkIndex].UniformExpression;
            if (OtherExpression && OtherExpression->IsIdentical(UniformExpression))
            {
                delete UniformExpression;
                AddCodeChunkToCurrentScope(ChunkIndex); // 直接复用已有的代码块
                return ChunkIndex;
            }
        }
        delete UniformExpression;
        UniformExpression = TestExpression; // 跨材质属性复用同一个表达式
        break;
    }
}
注意这段去重:表达式相同就直接复用已有结果。所以你在图里把 sin(Time * 2) 写两遍,编译结果里也只有一份计算——公共子表达式共享,不同材质属性(BaseColor、Emissive 等)之间也能复用同一份中间结果。
Preshader:跑在 CPU 上的"预着色器"
被折叠的计算并不是直接变成 C++ 留在引擎里,而是编译成一套独立的 CPU 字节码——Preshader。它支持的操作就是一套无像素差异的数学指令集:
// Engine/Public/Shader/Preshader.h(节选)
enum class EPreshaderOpcode : uint8
{
    Nop, ConstantZero, Constant, Parameter,
    Add, Sub, Mul, Div, Fmod, Min, Max, Clamp,
    Sin, Cos, Tan, Asin, Acos, Atan, Atan2,
    Dot, Cross, Sqrt, Rcp, Length, Normalize,
    Saturate, Abs, Floor, Ceil, Round, Trunc, Sign, Frac,
    Log2, Log10, ComponentSwizzle, AppendVector,
    ...
};
到了生成 HLSL 的阶段,折叠结果所在的位置会被替换成对 PreshaderBuffer 的读取——对 GPU 来说,那就是 uniform buffer 里一个现成的值:
// MaterialUniformExpressions.cpp:折叠结果的位置只生成一句 uniform 读取
OutResult.Appendf(TEXT("%s.PreshaderBuffer[%u]"), MaterialNamePrefix, RegisterIndex);
// 生成到 HLSL 里的效果:TexColor * Material.PreshaderBuffer[0]
编译期和改参数,各有一次 CPU 求值
Preshader 的结果不是编译一次就永远不变的。编译期,ShaderCompileWorker 会把这套字节码在 CPU 上跑一遍、填进 uniform buffer;而在你修改材质参数的时候,引擎走的是另一条路——不用重编 shader,但要重新执行 Preshader:
// FMaterialRenderProxy::EvaluateUniformExpressions(渲染线程,节选)
// CPU 上重算所有折叠表达式,填入临时 buffer
UniformExpressionSet.FillUniformBuffer(Context, OutUniformExpressionCache,
    UniformBufferLayout, TempBuffer, TempBufferSize);

// 再把结果上传 GPU
RHICmdList.UpdateUniformBuffer(UniformBuffer, TempBuffer);
调用链是 UMaterialInstance::RecacheUniformExpressions → FMaterialRenderProxy::CacheUniformExpressions_GameThread → 抛渲染命令 EvaluateUniformExpressions → FillUniformBuffer 重算 → UpdateUniformBuffer 上传。也就是说,改一个亮度参数,GPU 侧的 shader 一行没变,但所有跟这个参数相关的折叠中间结果,都要在 CPU 上重算一遍再传过去。材质参数越多、折叠链越长,这次重算就越贵——这就是改材质参数会有额外开销的原因。
Custom 节点:这套优化的"黑洞"
这套机制有一个明确的盲区:Custom 材质节点。翻译器处理 Custom 节点时,是把你写的 HLSL 原样包成函数塞进生成的代码里(FString Code = Custom->Code),节点内部在算什么,翻译器一概不知道——自然也就谈不上把哪一段折叠到 CPU。哪怕你在 Custom 里只写两个参数相乘,它也只能老老实实逐像素执行。
所以 Custom 节点真的该慎用。它存在的意义是写那些表达式节点组合不出来的复杂算法,不是为了写代码而写代码,更不是炫技。我也见过一些不明所以的 TA,能用节点连线解决的事也要搬进 Custom 里写 HLSL,甚至为了方便让 AI 生成材质,把大段大段的 HLSL 堆进 Custom 节点——这等于主动放弃引擎白送的常量折叠,每一段都在给 GPU 加无谓的逐像素开销。能连节点就别写 Custom,这是我对这个节点的基本态度。
写在最后
常量折叠不是免费的午餐:它省的是 GPU 指令,花的是 uniform buffer 的体积,以及每次参数变更时的 CPU 求值。但对我来说,真正有用的是一个判断习惯——写每一段计算的时候想一下,这段跟像素有没有关系:没有关系的,让它走节点、走折叠;有关系的,才值得留在 GPU 上逐像素算。比起背"少用 Custom""少用复杂节点"这种口诀,想明白这一条,材质优化就有方向了。